

當 AI 學會讀拉曼譜:分子識別正在變簡單
一張譜圖,到底難在哪?
拉曼光譜被稱作分子的「指紋」,正因為它夠豐富——但也因為太豐富,反而難讀。三個難點擺在面前:
峰的數目多、位置近。一個中等分子就有幾十個特征峰,還常常疊在一起,靠肉眼很難一一歸位。
背景與熒光干擾。真實樣品不是純物質,基質、熒光、噪聲混在一起,把「真正的信號」埋在下面。
解讀靠經驗。同樣是「看譜」,十年經驗的專家和剛入門的研究者,結論可能差很遠。
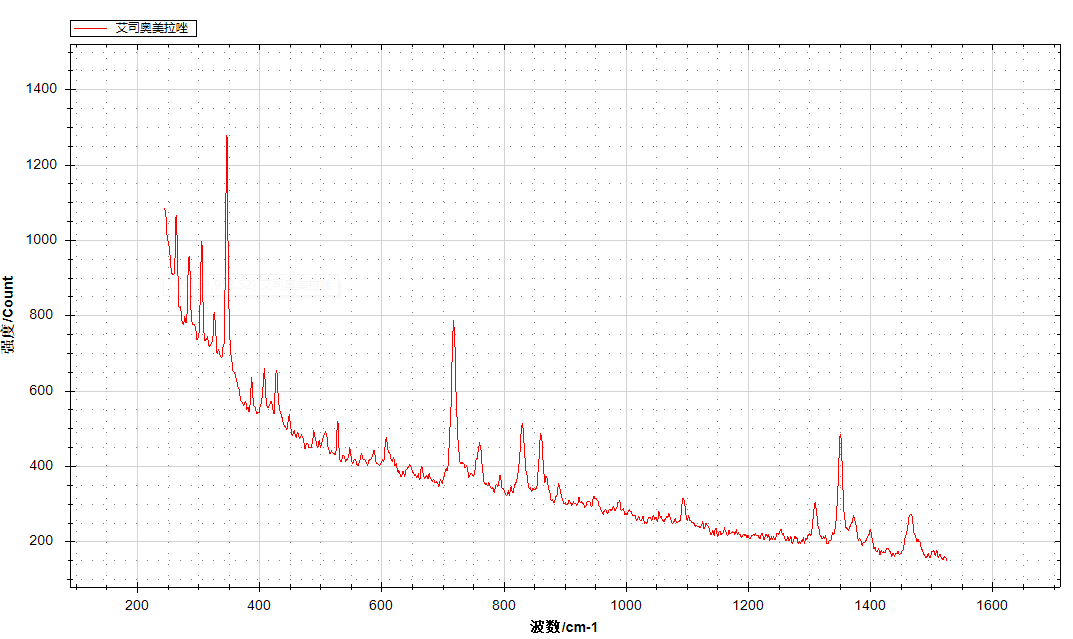
圖 1 一張典型拉曼實測譜圖 · AI 要學的,就是從這樣的峰里讀出結構信息
AI 是怎么「學會讀譜」的?
大致有兩條并行推進的技術路線,各有各的看家本領:
路線一 · 深度學習「認特征」。用卷積、注意力、殘差網絡這些深度學習結構,直接從海量譜圖里自動提取有用的特征,不再靠人手工挑峰。這是目前診斷、檢測類應用的主力。
路線二 · 大語言模型「會推理」。把光譜像文字一樣「編碼」,交給大語言模型去理解。如 2025 年提出的 SpectraLLM,把核磁、紅外、質譜等多種光譜塞進同一個模型聯合推理,在 6 個標準化學數據集上拿下當時最&優成績;反向路線 Mol2Raman 則能從分子結構直接預測拉曼譜,Vib2Mol 從拉曼譜反推分子,檢索準確率高達 98.11%。
① 拉曼光譜 · 一張指紋
② 特征編碼 · 數字化表示
③ 大模型推理 · 理解判斷
④ 分子結構 / 判定結果
示意圖 AI 處理拉曼光譜的遞進流程 · 顏色由淺入深,代表逐級深入
五個正在發生的改變
技術不再停在論文里。下面這些數字,來自 2023–2026 年間已經發表的研究——AI 與拉曼的聯用,正在一個個具體領域落地。
· 阿爾茨海默病早期篩查 AI 賦能的血清分子可解釋表面增強拉曼平臺(AMI-SERS)實現 96.67% 分類準確率,還能對光譜信號做「分子級溯源」——不再是只出結果、說不出原因的「黑箱」。
· 癌癥診斷 光纖拉曼結合 1D-CNN,在結直腸癌檢測中做到 89.9% 準確率、91.4% 精確率,模型能捕捉到與生物標志物相關的細微光譜特征。
· 微生物快檢 聲驅動裂解 + 殘差網絡(ResNet),在 7 種細菌樣本中達到 98.9% 分類準確率,超越傳統隨機森林分類器。
· 海水微塑料識別 注意力神經網絡 + 開集深度學習,聚合物類型識別 97%,老化狀態判別 93%,對訓練集沒見過的「新雜質」拒識率 97%,把閉集算法的假陽性風險壓低了四分之一。
· 食品酵母監測 單細胞拉曼自動采集 + CNN,對 15 種食品酵母做非破壞識別與代謝活性監測,一機完成分類、活性評估與計數。
不止「讀譜」,AI 也在加速「讀圖」
拉曼的能力早就不止于單點光譜。顯微拉曼一路掃描下來,能把某種成分在樣品表面的空間分布「畫」成偽彩色圖——成分分布、制劑均勻性、材料缺陷一目了然。
這樣的成像圖,一張就有成千上萬個像素點,每個點都是一條譜。靠人逐條讀,工作量驚人;交給 AI,則能成批量、成系統地提取分布規律。從「單點解讀」到「全域解析」,AI 把拉曼成像的價值又往前推了一步。
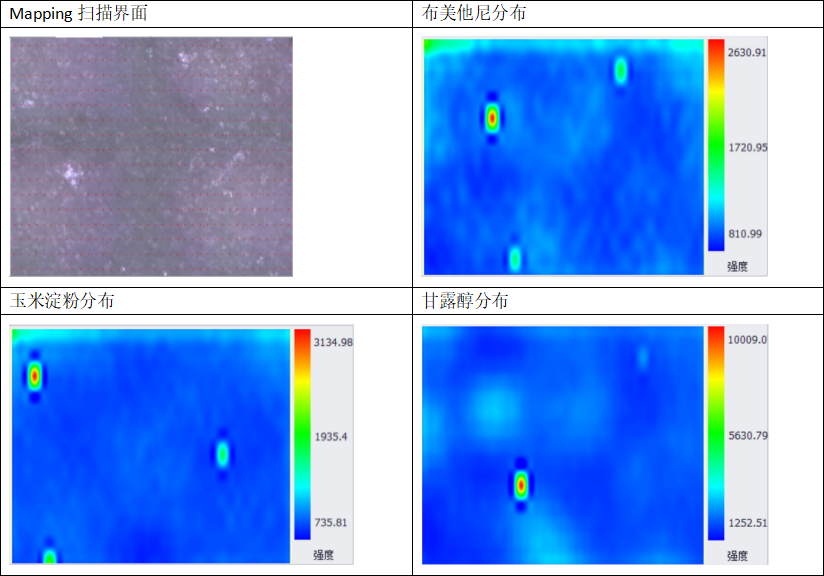
圖 2 拉曼掃描成像實測 · 不同成分在樣品表面的空間分布被拆解成一張張「地圖」
剩下的坎,卡在哪?
趨勢是真的,攔路的問題也是真的,我們不妨攤開講:
① 數據稀缺。高質量實驗光譜少、分布還不均衡,模型容易「偏科」;
② 域差異。實驗測的和計算模擬的譜,長得不一樣,直接遷移會失準;
③ 可解釋性。模型給結論、卻說不出為什么,是進入臨床和監管的最大門檻;
④ 缺統一基準。各家用各家的數據、各測各的指標,結果不好橫向比。
一句話:AI 已經很能干,但還沒到「讓人完&全放心」的程度。剩下的路,需要數據、算法和標準一起補。
落點:高質量譜圖,才是 AI 的「糧食」
聊了這么多 AI,繞不開一個更根本的問題:喂給模型的譜,得先夠干凈、夠穩定、夠一致。
噪聲大、峰位飄、信噪比低的數據,AI 學了反而「學壞」。這正是好儀器存在的前提——無論是現場快速識別用的手持拉曼,還是實驗室做高分辨成像的顯微共聚焦拉曼光譜成像儀,生產的每一條高質量譜圖,都是未來 AI 模型的訓練樣本和推理輸入。
換句話說,「AI + 拉曼」這件事要想走得遠,第一步永遠是穩定可靠的光譜采集。工具與智能,從來不是二選一,而是同一條鏈路上的前后兩級。

